 Status








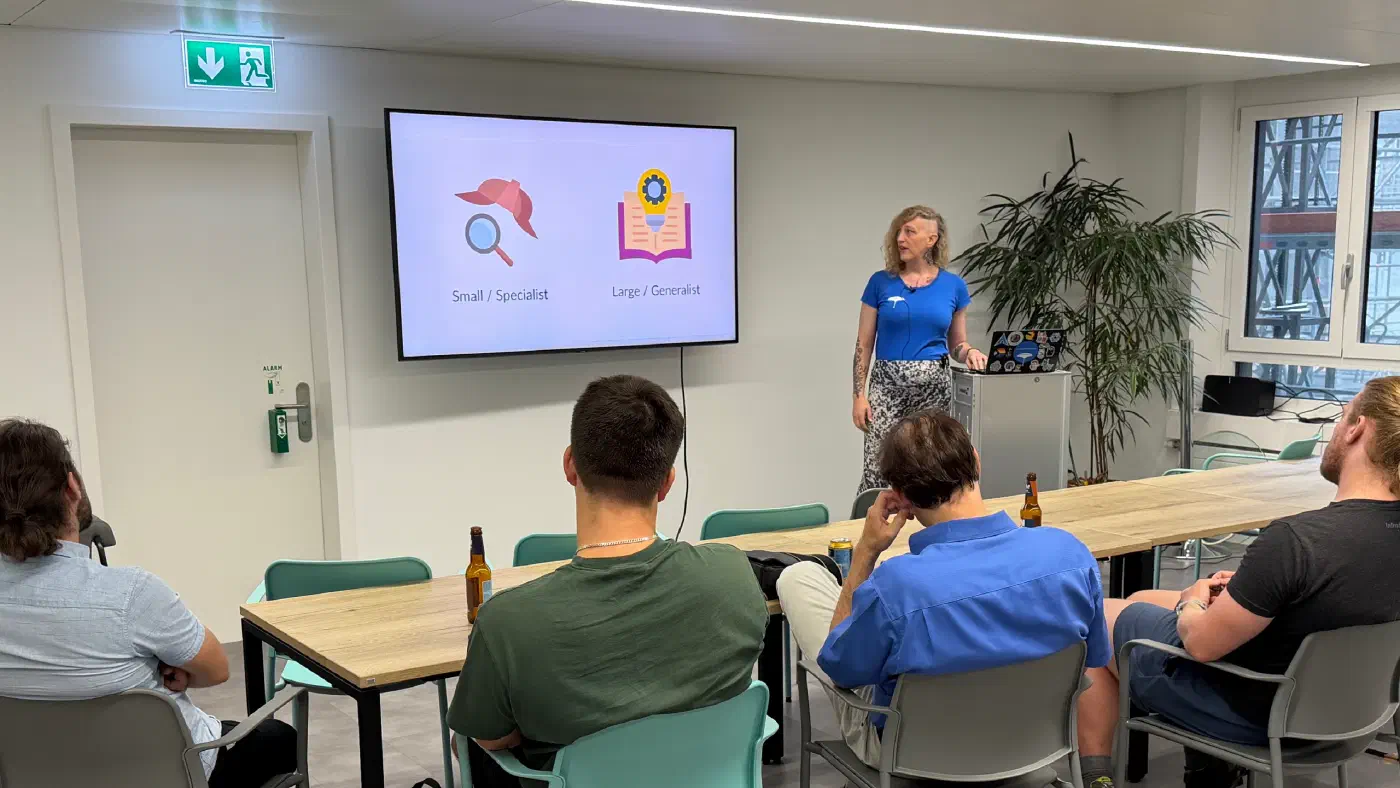
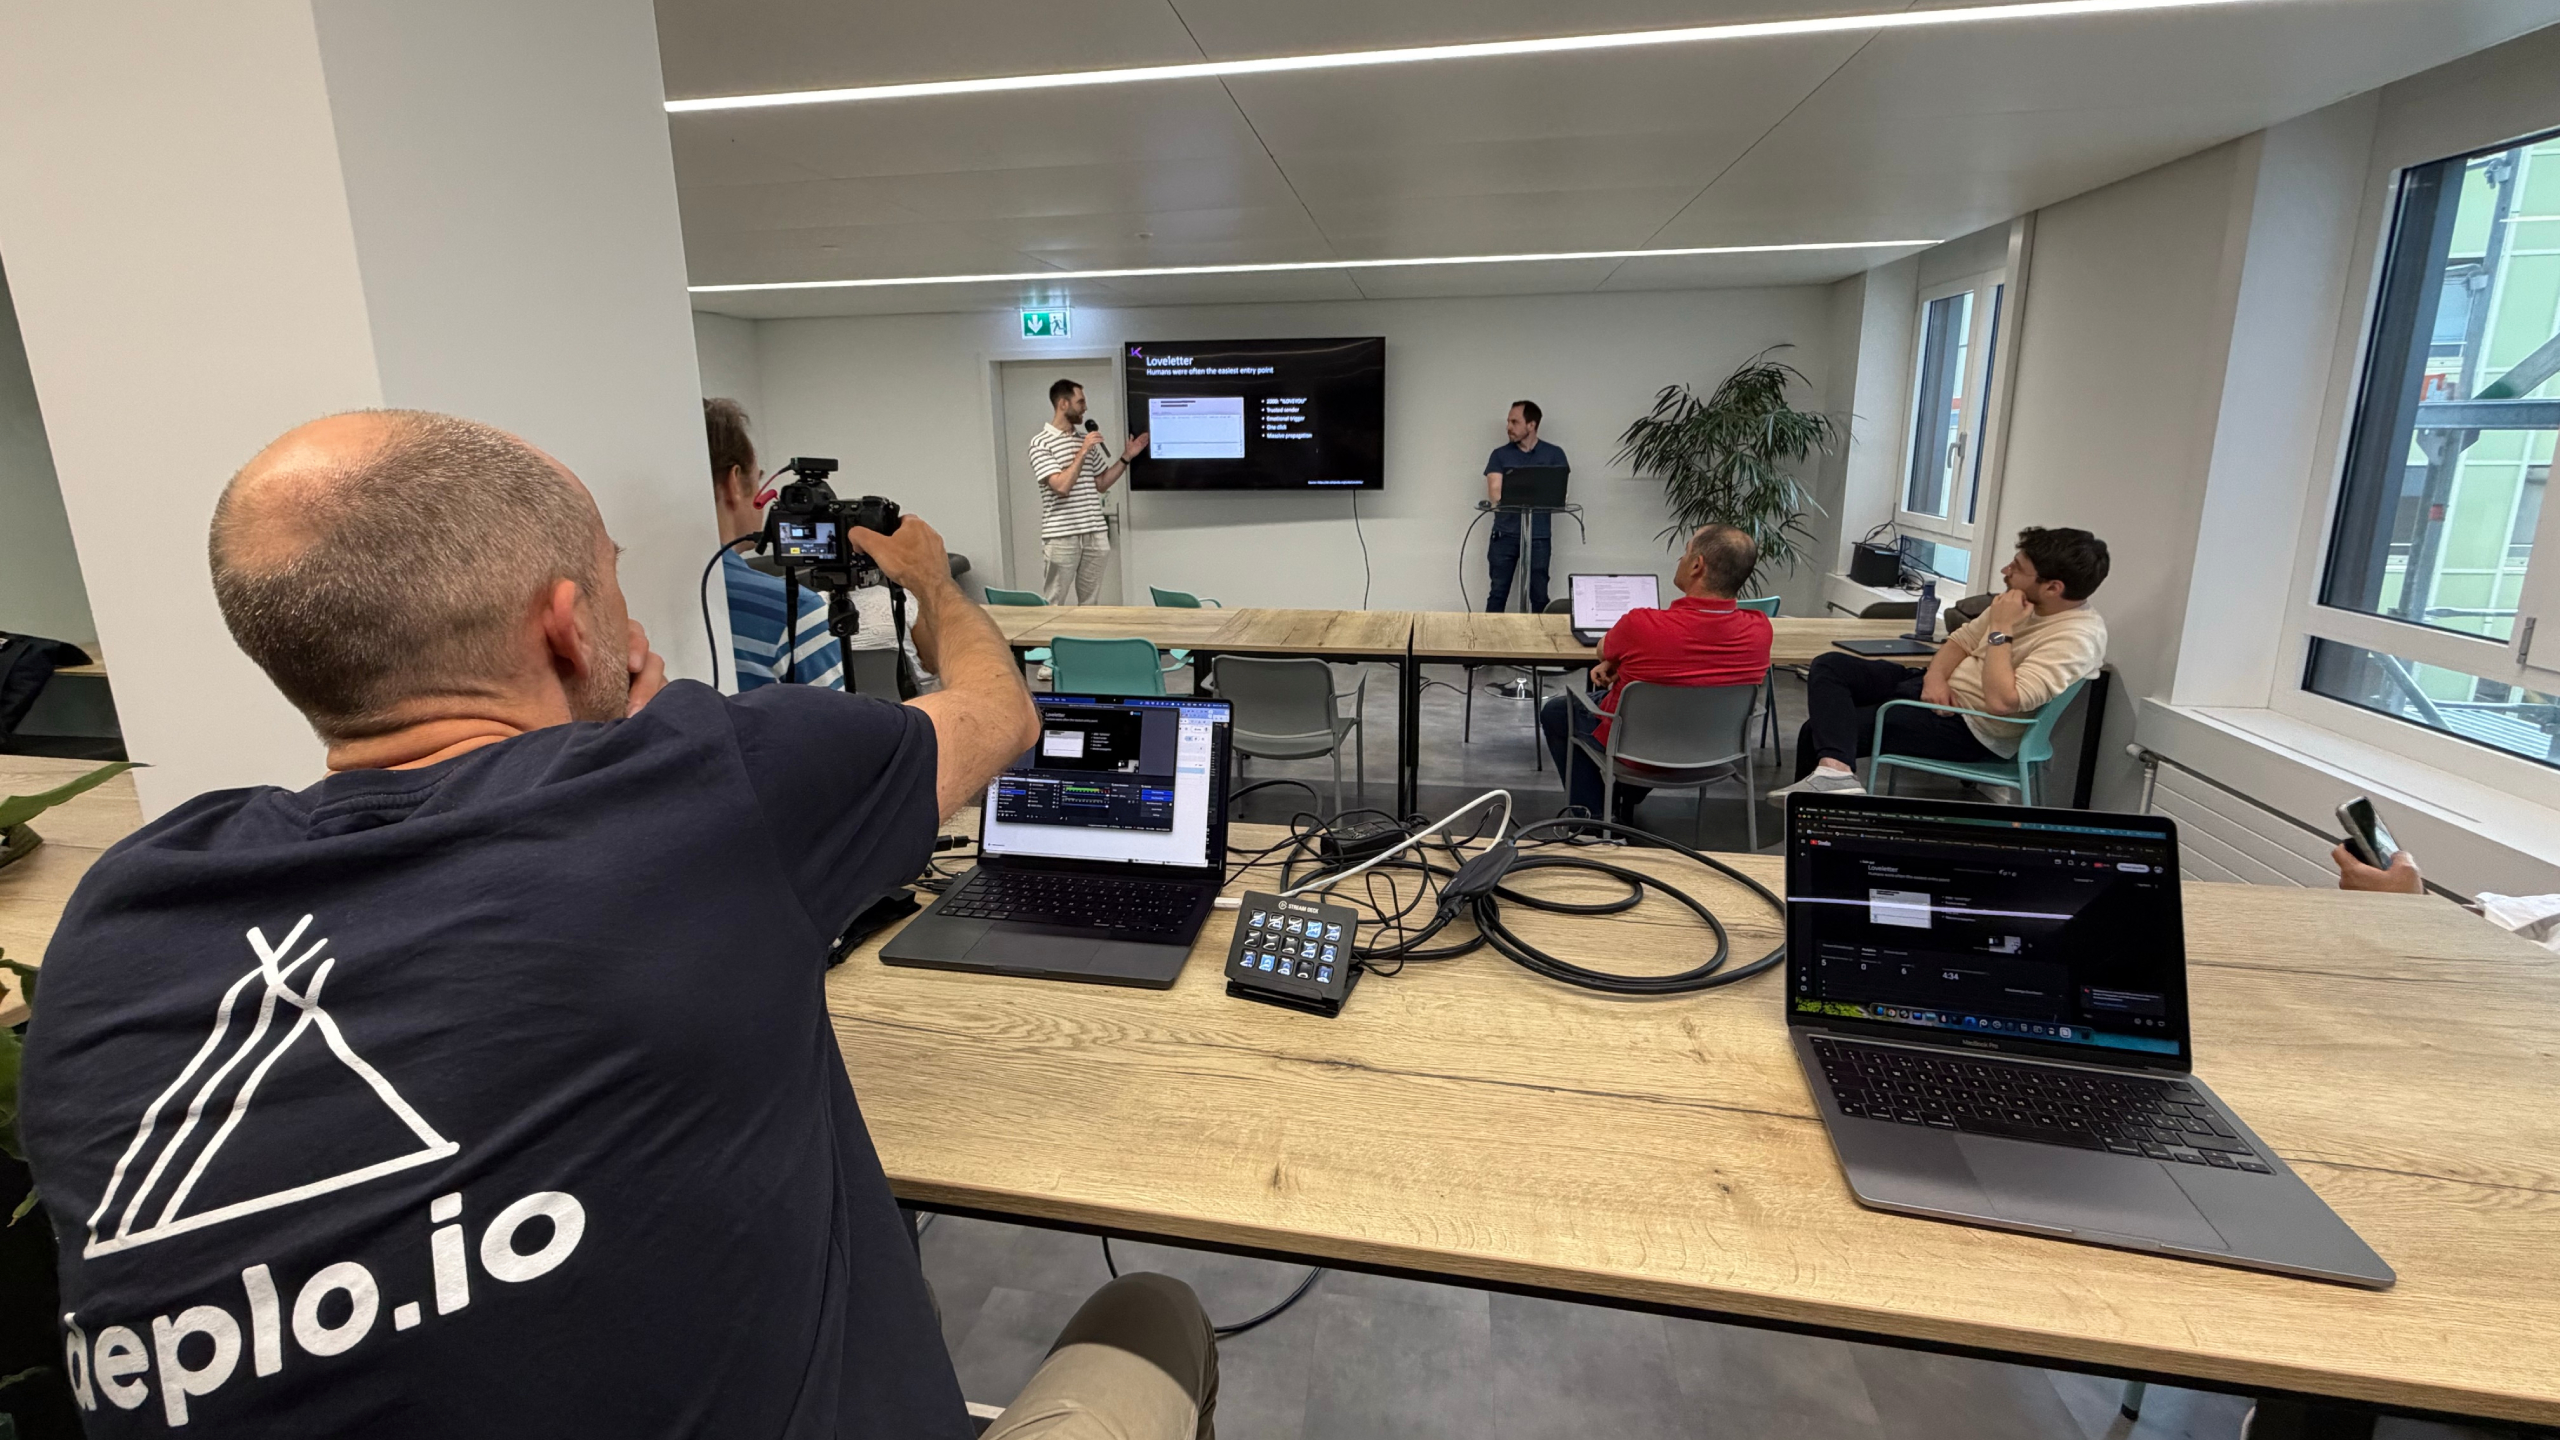


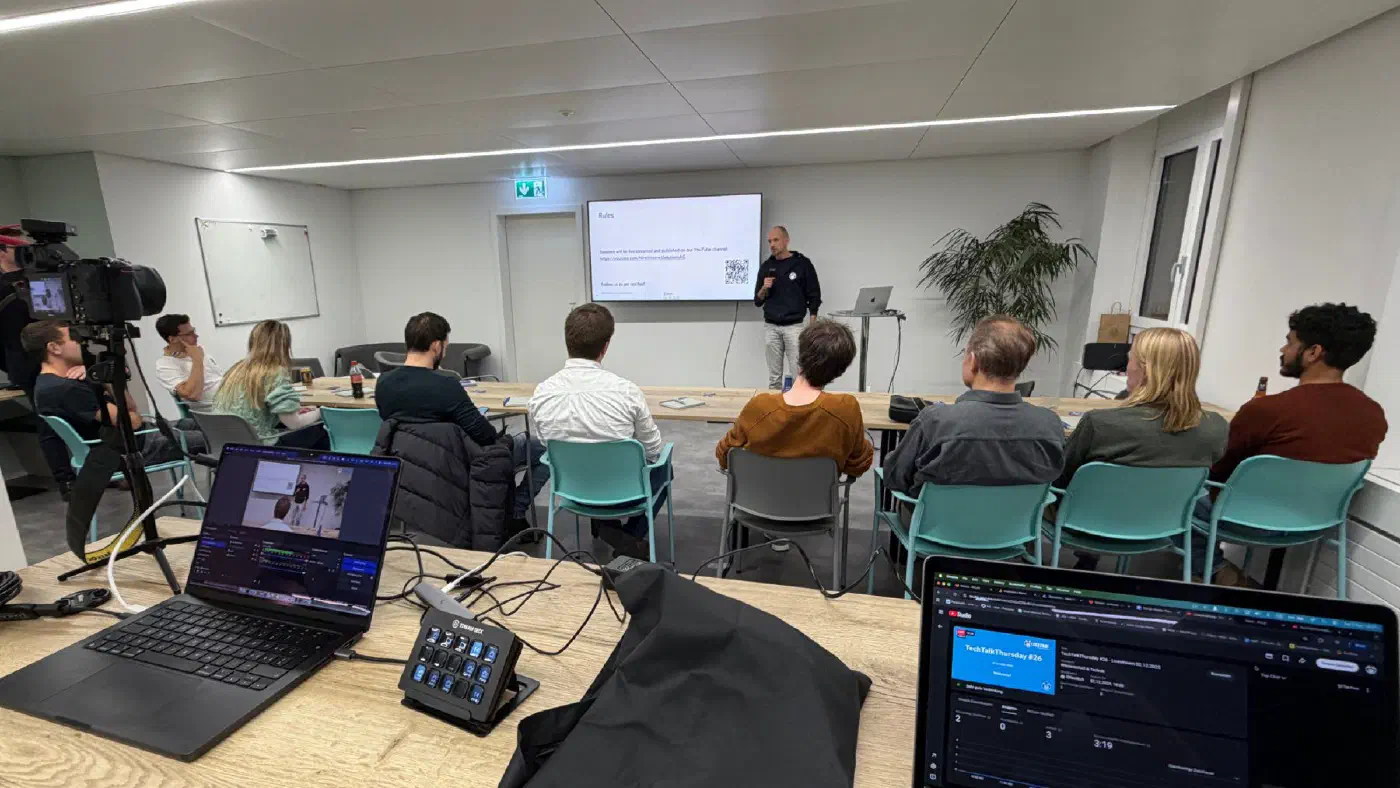
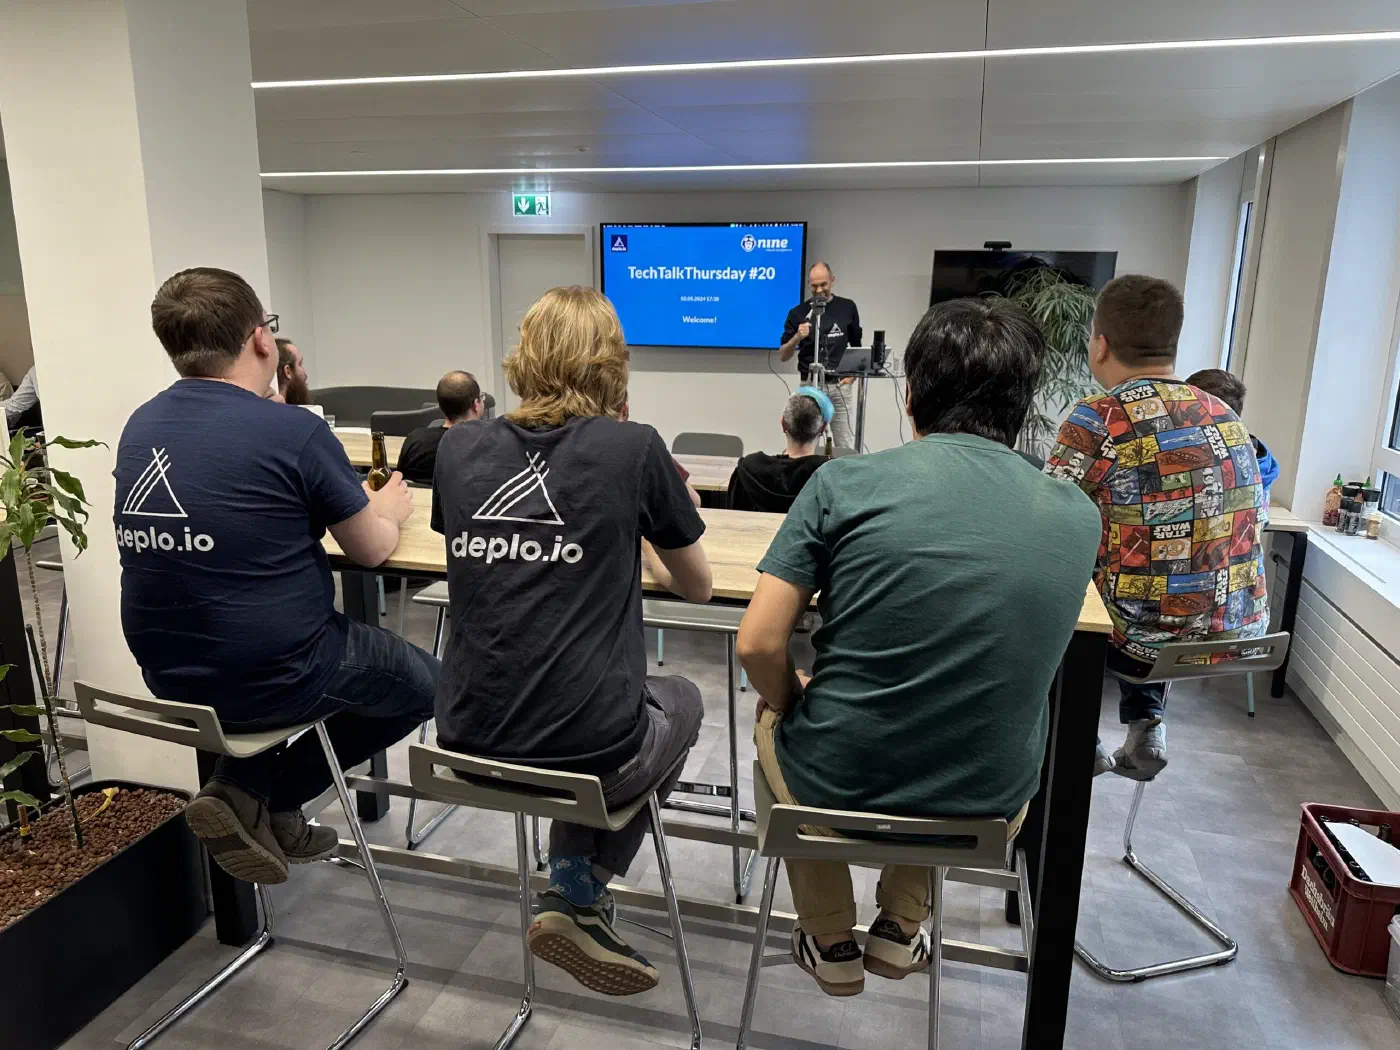
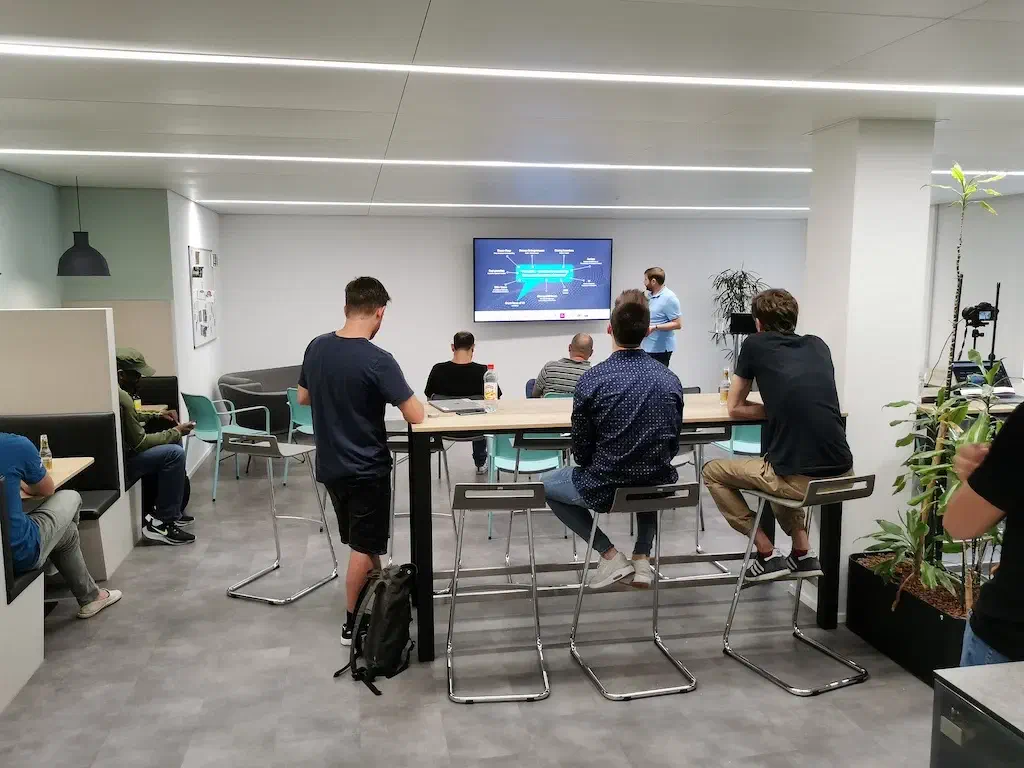






Weshalb sollte es dir überhaupt wichtig sein, wo das Modell deines Chatbot läuft? Genau darauf lieferte Lena Fuhrimann, Gründerin und Cloud Solution Architect bei bespinian, am TechTalk #29 einige unbequeme Antworten, gefolgt von einer wirklich handfesten Anleitung, wie man sich von den grossen KI-Anbietern unabhängig macht.
Warum es zählt, wo dein Modell läuft
Ihr erstes Argument drehte sich um Datenschutz. Nachdem ein kurzlebiges Feature für «auffindbare» Chats bei Google missglückte, landeten tausende ChatGPT-Unterhaltungen im Google-Index, manche davon mit sensiblen persönlichen Informationen. In einem separaten Fall verpflichtete ein US-Gericht OpenAI im Rahmen einer laufenden Klage dazu, Chat-Logs aufzubewahren, die Nutzende ausdrücklich hatten löschen lassen wollen. Statt die Anordnung klaglos umzusetzen, wehrte sich OpenAI gegen diese. Beiden Unternehmen möchte dabei sicher niemand Fahrlässigkeit unterstellen, trotzdem zeigen beide Fälle, wie wenig Kontrolle über die eigenen Gespräche und Inhalte bleibt, sobald sie die eigene Infrastruktur verlassen haben.
Beim zweiten Argument ging es ums Geld. Trotz gewaltiger Investorengelder schreiben weder OpenAI noch Anthropic unter dem Strich Gewinn: Anthropic wies im ersten Halbjahr 2026 einen Nettoverlust von über 80 Milliarden Dollar aus, OpenAI erwartet für 2026 einen Verlust von rund 14 Milliarden Dollar. Diese Lücke muss sich früher oder später schliessen: über Werbung oder über steigende Preise. Für Nutzende ist keines dieser Szenarien von Vorteil.
Das Pendel
Wie es weitergeht, erklärte Lena mit einem Bild: Die IT pendelt seit jeher zwischen Zentralisierung und Dezentralisierung, vom Mainframe zum PC, vom PC zur Cloud, von der Cloud zum Smartphone in der Hosentasche. Aktuell schlägt der KI-Trend stark in Richtung Zentralisierung aus, mit gigantischen Summen, die unter anderem Amazon, Microsoft, Alphabet und Meta gerade in Rechenzentrumskapazitäten investieren.
Sie wettet darauf, dass das Pendel zurückschwingt. Schon heute dienen proprietäre Spitzenmodelle dazu, Open-Source-Modelle zu trainieren, wodurch sich der Abstand zwischen beiden Welten deutlich verringert hat: Brauchten Open-Source-Modelle früher über ein Jahr zum Aufholen, reichen inzwischen teils rund sechs Monate. DeepSeek ist dafür das bekannteste Beispiel. Gleichzeitig wird auch Consumer- und Workstation-Hardware laufend leistungsfähiger, Berichten zufolge waren Apples neue M5-Max- und -Ultra-Chips bereits Minuten nach Verkaufsstart ausverkauft. Zusammen mit steigenden Preisen bei den proprietären Anbietern spricht das eher dafür, dass lokale, offene Modelle auf eigener Hardware die wahrscheinlichere langfristige Richtung sind, nicht bloss Wunschdenken.
Realistisch bleiben
Dabei übertrieb Lena bewusst nicht, was tatsächlich machbar ist. Sie teilt offene Modelle grob in drei Kategorien ein: kleine Modelle bis rund 35 Milliarden Parameter, die problemlos auf einem Laptop laufen, mittlere im Bereich mehrerer hundert Milliarden Parameter, für die es eine leistungsfähige, dedizierte GPU oder einen kleinen GPU-Cluster braucht, und Modelle jenseits der Billionen-Parameter-Grenze, die tatsächlich mit den Spitzen-Modellen mithalten können, dafür aber ein komplettes Rechenzentrum voraussetzen. Für Hobby-Anwender und kleine Teams sind die ersten beiden Kategorien das realistische Ziel, die dritte nicht.
Den eigenen Stack aufbauen
Anders als oft angenommen ist der eigentliche Engpass nicht Rechenleistung, sondern Arbeitsspeicher, genauer VRAM. Die Quantisierung, also das Abrunden der Gewichtung eines Modells auf eine geringere Genauigkeitsstufe, ist das wichtigste Mittel, um diesen Bedarf zu verringern, was jedoch zu Lasten der Genauigkeit geht (die Gemma-Modelle von Google sind ein gutes öffentlich zugängliches Beispiel dafür, welchen Unterschied dies macht). Auf der Architekturseite leiten Mixture-of-Experts-Modelle jedes Token über einen schlanken Router nur an eine kleine, relevante Untermenge der Parameter weiter, statt es durch sämtliche Parameter laufen zu lassen. Das beschleunigt die Inferenz, spart aber, anders als die Quantisierung, keinen Speicher. Zusammen erklären beide Konzepte auch die sonst kryptischen Modellnamen auf Hugging Face: Ein 4-Bit-quantisiertes Mixture-of-Experts-Modell mit 3 von insgesamt 35 Milliarden aktiven Parametern taucht im Dateinamen exakt so auf.
Als Hardwareanforderung nennt sie als Faustregel etwa 1,5 Gigabyte VRAM pro Milliarde quantisierter Parameter. Schon eine Consumer-GPU mit 12 Gigabyte reicht für einfache Klassifikation und simple Fragen aus. Mit einer Profi-Karte wie Nvidias RTX Pro 6000 und ihren 96 Gigabyte lässt sich ein 120-Milliarden-Parameter-Modell sogar für mehrere Nutzende gleichzeitig betreiben. Eine besondere Erwähnung verdient Apples eigene Unified-Memory-Architektur: Sie erlaubt es dem M5 Max und Ultra, bis zu 128 beziehungsweise 512 Gigabyte zwischen CPU und GPU zu teilen. Auf der Software-Seite bildet llama.cpp weiterhin die flexible, aber komplexe Basis, auf der die meisten Tools aufsetzen. Ollama gibt dafür etwas Flexibilität auf und gewinnt Benutzerfreundlichkeit, während vLLM zusätzliche Effizienzgewinne mitbringt, allen voran Paged Attention: Speicher für die Modellantwort wird dabei schrittweise reserviert, während sie entsteht, statt von vornherein den gesamten Worst-Case-Block zu blockieren.
Was wir daraus mitnehmen
Zum Schluss riet Lena, bewusst auf kleinere Modelle zu setzen: Ein kleineres, spezialisiertes Modell erledigt die tatsächliche Aufgabe oft ebenso gut wie ein grosses Generalisten-Modell, nur ohne dessen Speicherhunger. Diese Disziplin ist auch für uns wertvoll. Genau für die zweite Grössenklasse in Lenas Einteilung, also Workloads, die echte GPU-Leistung, aber kein ganzes Rechenzentrum brauchen, sind unsere eigenen GPU-Server gemacht. Ihr zentraler Punkt, dass Kontrolle über die eigenen Daten mit Kontrolle über die eigene Infrastruktur beginnt, gilt genauso, wenn diese Infrastruktur zufällig in der Schweiz steht.
Welche Fragen du dir vor dem Aufbau eigener AI-Infrastruktur stellen solltest, haben wir ausführlicher in unserem Beitrag zum Training eigener LLMs statt bei US-Hyperscalern beschrieben. Mehr zu unseren GPU-Servern gibt’s auf unserer Produktseite. Hast du Fragen zu einem der Themen aus dem Talk? Melde dich bei uns. Den nächsten TechTalk kündigen wir wie gewohnt über unsere Kanäle an, unter anderem in unserer Meetup-Gruppe «TechTalk @ Nine».
